Computer Vision

Python, Computer Vision, AI, Transhumanism 関連

衛星は大網白里の豪雨をどう捉えたか

――Sentinel-1で見る2026年8月の冠水(可能性)

2026年8月13日、千葉県では記録的な大雨となり、大網白里市周辺でも道路や農地の冠水が相次いだ。


今回の大雨では、人的被害も報じられており、被害に遭われた方々にお見舞い申し上げます。


本記事では、公開されている衛星データと報道資料をもとに、豪雨前後の大網白里市周辺の変化を確認したものです。

14日に撮影された報道写真を見ると、JR大網駅の周辺には茶色く濁った水が広がり、道路、駐車場、宅地、農地の境界が分かりにくくなっている。ヘリコプターからの映像でも、水田地帯が大きな湖のように見える場所や、水に囲まれた住宅、冠水した鉄道沿線などが確認できる。


今回、この豪雨の前後に撮影された人工衛星の画像をGoogle Earth Engineで比較し、大網白里市周辺のどこで地表の状態が大きく変わったのかをみていく。


雲の上から水害を見るSentinel-1

解析に使用したのは、欧州宇宙機関の地球観測衛星「Sentinel-1」である。

Sentinel-1は、通常のカメラではなくマイクロ波を地表へ照射するSAR(合成開口レーダー)を搭載している。雲に覆われていても、昼夜を問わず地表を観測できることが大きな特徴だ。


豪雨災害の直後は厚い雲が残ることが多い。実際、今回利用できたSentinel-2の光学画像は、豪雨前の8月9日が雲量約49%、豪雨後の8月14日が約68%だった。地表の多くが雲に隠れ、光学画像だけで冠水域を確認するのは難しかった。

その点、Sentinel-1は雲の影響をほとんど受けない。そこで、豪雨前と豪雨直後の同じ観測軌道の画像を比較した。


解析条件は次のとおりである。

  • 対象範囲:大網白里市中心部から半径約8km

  • 豪雨前:2026年8月1日のSentinel-1画像

  • 豪雨直後:2026年8月13日夜(日本時間では14日早朝)の画像

  • 観測方向:DESCENDING(下降軌道)

  • 相対軌道番号:46

  • 使用偏波:VV・VH

観測条件が異なる画像を単純に比較すると誤差が大きくなるため、今回は同じ軌道の画像を選んだ。


豪雨後に暗くなった場所を抽出する

SAR画像では、滑らかな水面はマイクロ波を衛星とは別の方向へ反射するため、一般に暗く写る。

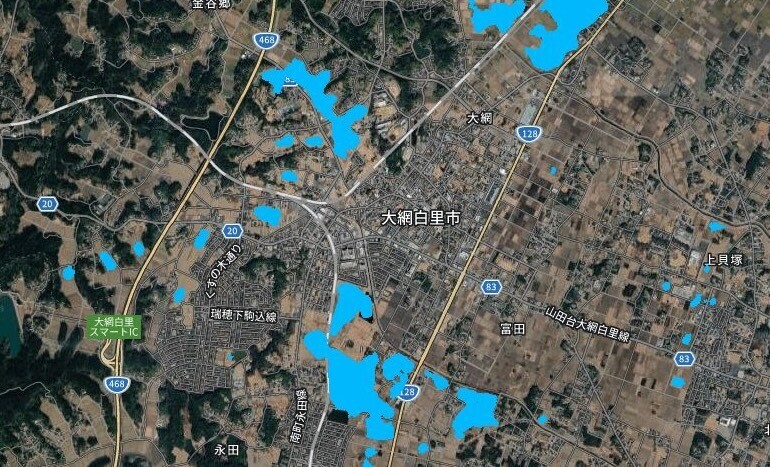
そこで、豪雨前よりも豪雨後の反射が大きく低下した場所を抽出した。さらに、細かなノイズを抑える処理を加え、JRC Global Surface Waterのデータを使って、池や河川など普段から水が存在する場所をできるだけ除外した。

その結果、大網白里市周辺の低地に多数の「冠水候補」が現れた。

候補域は、大網駅周辺だけでなく、東金線沿線や駒込・永田方面、その先の低平な農地にも広がっている。大きなまとまりの多くは水田地帯と重なっていた。

約421haという数字の意味

今回の条件で抽出された冠水候補の合計は、対象範囲内で約421haとなった。

ただし、この数字をそのまま「実際に浸水した面積」と読むことはできない。

SARの反射は、冠水以外の理由でも変化する。例えば、次のような場所が候補に含まれる可能性がある。

  • もともと水が張られていた水田

  • 雨で非常に湿った土壌

  • 強風や大雨で稲が倒れた場所

  • 建物や樹木によってレーダーの影になる場所

  • 観測角度の影響を受けた斜面や構造物

したがって、約421haという値は、行政が調査した被害面積ではなく、「豪雨の前後でSARの反射が冠水時に見られる方向へ大きく変化した範囲」の暫定値である。

正確な浸水面積を確定するには、現地調査、自治体の被害記録、より細かな標高データ、土地利用情報などとの照合が必要になる。
報道写真と一致する大網駅東側

衛星解析を検証するうえで特に重要だったのが、2026年8月14日午前9時16分に撮影された共同通信の航空写真である。

写真にはJR大網駅が写っており、線路の曲線、県道83号、駐車場、太陽光パネル、住宅、水路などをGoogleの航空写真と照合できる。

写真の中心は、おおむね北緯35.5232度、東経140.3172度付近。大網駅の東側から北東側に当たる。


通常の航空写真では道路、農地、宅地が明確に分かれているが、報道写真では低い土地の多くが濁水に覆われている。ここは、Sentinel-1で反射の変化が確認された地域とも近い。


この一致から、衛星画像に現れた変化の少なくとも一部は、実際の冠水を捉えている可能性が高いと考えられる。


共同通信の写真:
記録的な大雨で冠水したJR大網駅周辺


空撮映像から見える広域的な影響

ANNnewsCHで公開されているヘリの空撮には、大網白里市をはじめ、本納駅や蘇我駅など複数の地域が撮影されている。

視聴者のコメントも参考にすると、映像は大網駅周辺から東金線の福俵駅方面へ進み、その後、外房線の永田・本納方面、さらに蘇我駅や千葉市内へ移動したようだ。


そのため、映像に登場するすべての冠水場所を「大網駅周辺」として扱うことはできない。一方で、大網駅から福俵駅へ延びる東金線沿線や、永田駅から本納駅周辺の低地でも、大規模な滞水が発生していた可能性を示す資料といえるだろう。


ANNの空撮映像:
【ヘリ空撮・緊急ライブ】千葉で記録的豪雨 一夜明けての状況は?

なぜ大網駅周辺に水が集まるのか

大網駅周辺の地形を見ると、西側には土気方面へ続く丘陵があり、東側には九十九里平野の低く平坦な土地が広がっている。

短時間に大量の雨が降ると、丘陵側から流れてきた水が低地に集まる。一方、東側は海まで緩やかな地形が続くため、水が短時間で排出されにくい。

河川から水があふれる洪水だけでなく、排水路や下水道の能力を雨量が上回る「内水氾濫」も起こりやすい条件だ。

大網白里市の計画にも、金谷川の流下能力を高める河川改修とともに、「大網駅周辺の浸水被害等軽減に向けた内水対策」の検討が記載されている。


市の計画資料:
大網白里市第6次総合計画 前期実施計画 

https://www.city.oamishirasato.lg.jp/cmsfiles/contents/0000015/15138/zj2025.pdf


衛星画像は被害の全体像を補う

報道写真や現地映像は、実際に水が存在したことを直接確認できる。一方、撮影された場所は限られている。

衛星画像の強みは、現場の細部を確認することではなく、同じ条件で広い地域を見渡せることにある。

今回の解析では、報道された大網駅周辺だけでなく、その外側の水田地帯にも多数の変化域が現れた。これらがすべて冠水したとは断定できないが、豪雨による影響が駅前の道路だけに限られず、周辺の低地へ面的に広がっていた可能性を示している。

一方で、光学衛星Sentinel-2は雲に遮られ、豪雨直後の状況を十分には確認できなかった。今後、雲の少ない画像が追加されれば、泥の堆積、植生の変化、水が引いた後の地表状態なども調べられる可能性がある。


おわりに

今回の解析から見えてきたのは、大網白里市の冠水が道路の一点だけで起きた現象ではなく、大網駅周辺から鉄道沿線、さらに周囲の低平な農地へ広がった可能性である。


Sentinel-1が示した冠水候補は約421ha。ただし、これは現地で確認された被害面積ではなく、水田や湿った地面などを含む可能性がある暫定的な解析結果である。


それでも、報道写真で実際に冠水が確認された場所と、衛星画像上の変化が近い位置に現れたことには意味がある。


雲に覆われ、地上から全体を見渡せない災害直後でも、SAR衛星は広域的な変化を記録できる。現地映像、航空写真、地形、防災情報と組み合わせることで、豪雨が地域にどのような影響を与えたのかを、より立体的に捉えることができる。


※本記事の解析はGoogle Earth Engine上で公開衛星データを用いて行った独自解析です。表示した冠水候補および面積は、行政機関が調査・公表した被害範囲ではありません
100円のカメラを買ったら時間が溶けた話

秋月電子で、10年以上ひっそりと売られ続けている、¥100のカメラモジュールがある。


GCM0105-1003E


商品説明は実質一行 ——「詳細不明の為特価」。データシートなし、ピン配置不明、動作電圧も不明。


ネットを漁っても「撮れた」という記録は日本語も英語も一件もない。


これは、そんな正体不明の¥100カメラにテスター片手に戦った闘争の記録である。


まずは、この¥100カメラが何者なのかという話から。


きっかけは、チャッピー(ChatGPT)

話が長くなるので、詳細は省くが、安いカメラが欲しくて、チャッピーにきいてみたらこんなのあるよとおすすめしてきた。


秋月にそのようなカメラがある事は、以前から知ってたのだが、「そんな得体の知れないカメラを買っても使えないのでは?」と思っていたので、買う事はなかった。しかし、連休中にでもちょっと試してみようかなという気持ちが芽生えてポチることに。


ブラウザで用件を伝えると、他の必要パーツも含め、チャッピーが秋月のカートに入れてくれた。

しかし、決済画面の手前で立ち止まった。

ボタンを押すのは人間の役目だと言い出した。

いや、それもうおねだりの常套手段やん。とか思いつつ、¥100カメラをポチっとな。5個で¥500。
(その後おきる数々の苦難をこの時の私はまだ知らない...。)


カメラは¥100でも、動かすには周辺がいる。他にも、ブレッドボード、ジャンパーワイヤー、テスター(これは持ってた)、ハンダゴテ、半田、コンデンサ、レギュレータ、ダイオード、抵抗……。細かな部品表は後日まとめるとして、とにかく一式そろえた。


まずは図面やスペック表をあたる。特許出願らしきものは引っかかるが、仕様まで読み解けるものはない。


というわけで、ここから先の配線計画は Claude Code におまかせ。

(おまかせと言っても、picoの足のハンダづけと、20本以上の配線。)


改めてこの部品の素性を並べると、なかなか謎めいている。


  • 8×8×5.5mm、重さ0.4g。25芯のフラットケーブル付き
  • マクロ切替レバー付き(機械式)
  • 在庫は2016年に23,927個 → 2026年で約13,650個。10年で1万個しか減っていない


データシートなし。ピン配置不明。ネットを漁って見つかったのは、2016年に分解レポートを書いたブログ1件きり(mswinvks氏の備忘録。偉大な先人である)。動かした記録は、日本語でも英語でも見つからなかった。


つまりこの部品、発売からずっと「誰にも使われたことがない」可能性が高い。10年、秋月の棚で eternal していたのである。


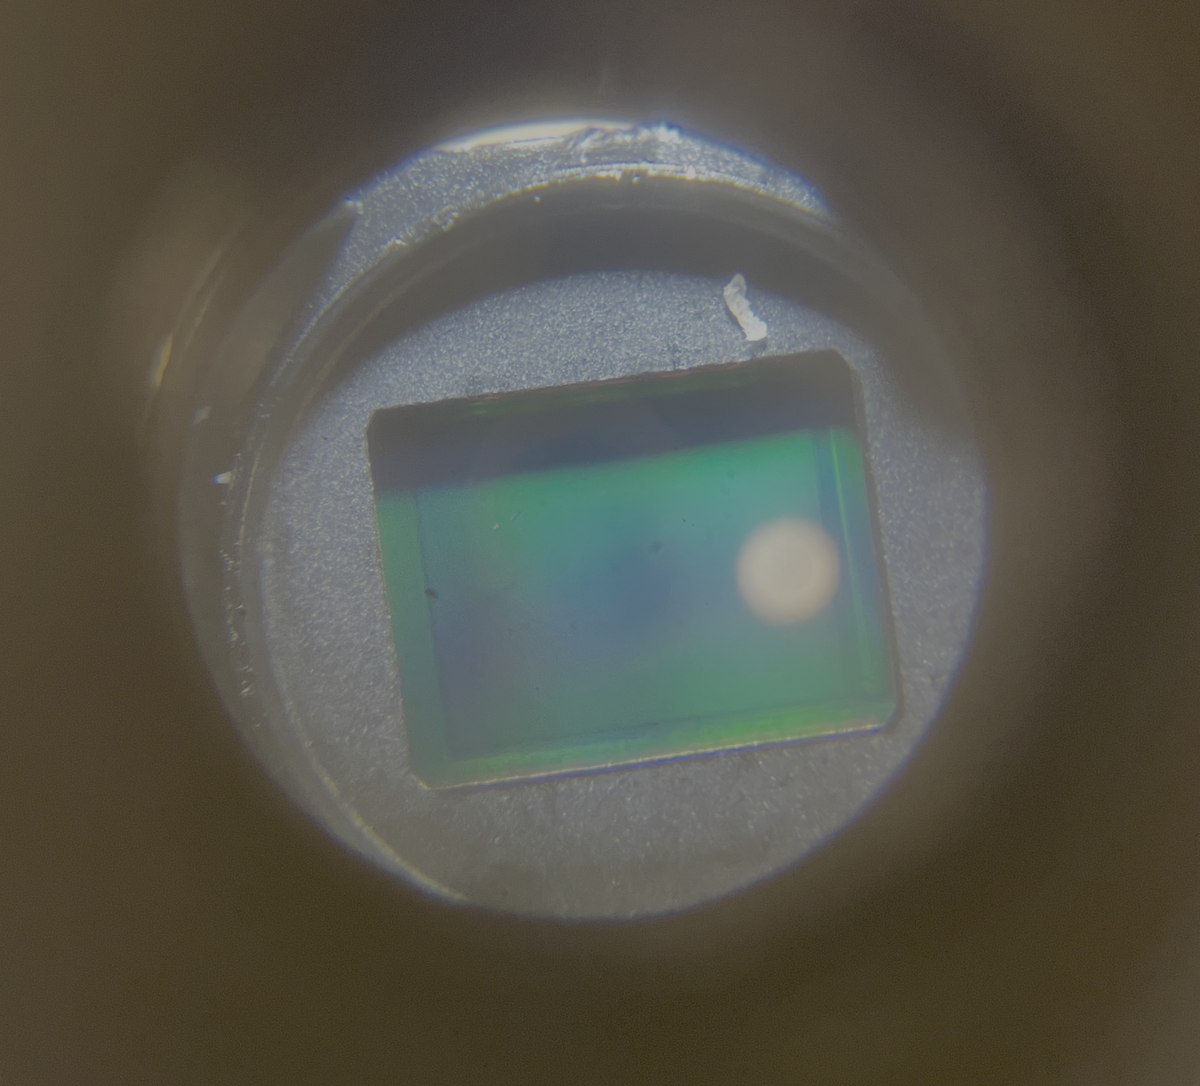
分解した1個。レンズの奥に、緑色に輝くベイヤーフィルタの画素アレイが見える。刻印は「C5」のみ。素性は最後まで不明だった。


正体を調べる(考古学)

物は2008年製(部品ブローカーDBのD/Cコードによる)。手がかりを一本ずつ手繰っていく。


  • 部品DBに「Maker: SMK」の記載 → SMK株式会社(東京の老舗コネクタメーカー)
  • SMKの特許 特開2010-164892(オートフォーカスカメラモジュール)の機構が、実物のマクロレバーと一致
  • SMK純正ソケット CLE9124-1501F が「8×8mmカメラモジュール用・24接点」—— 実測フレキ(25芯)とほぼ一致(ソケット側は24接点。1本はダミーか機械保持用と推定)
  • そして Wayback Machine から決定打:SMK公式の2006年10月プレスリリース「小型低背型SXGAカメラモジュール」。8×8mm・SXGA(130万画素クラス)・マクロ機能付き・携帯電話向け・月産30万個。公式カタログPDFも発掘した(マクロレバー角30°まで実物と一致)

つまりこれは「詳細不明の謎部品」ではなく、SMKが2007年前後に量産していた携帯電話用カメラの残余在庫と推定される。

ガラケー全盛期の日本のモノづくりが、秋月の棚で10年眠っていたわけだ。


電気的にこじ開ける(リバースエンジニアリング工程)

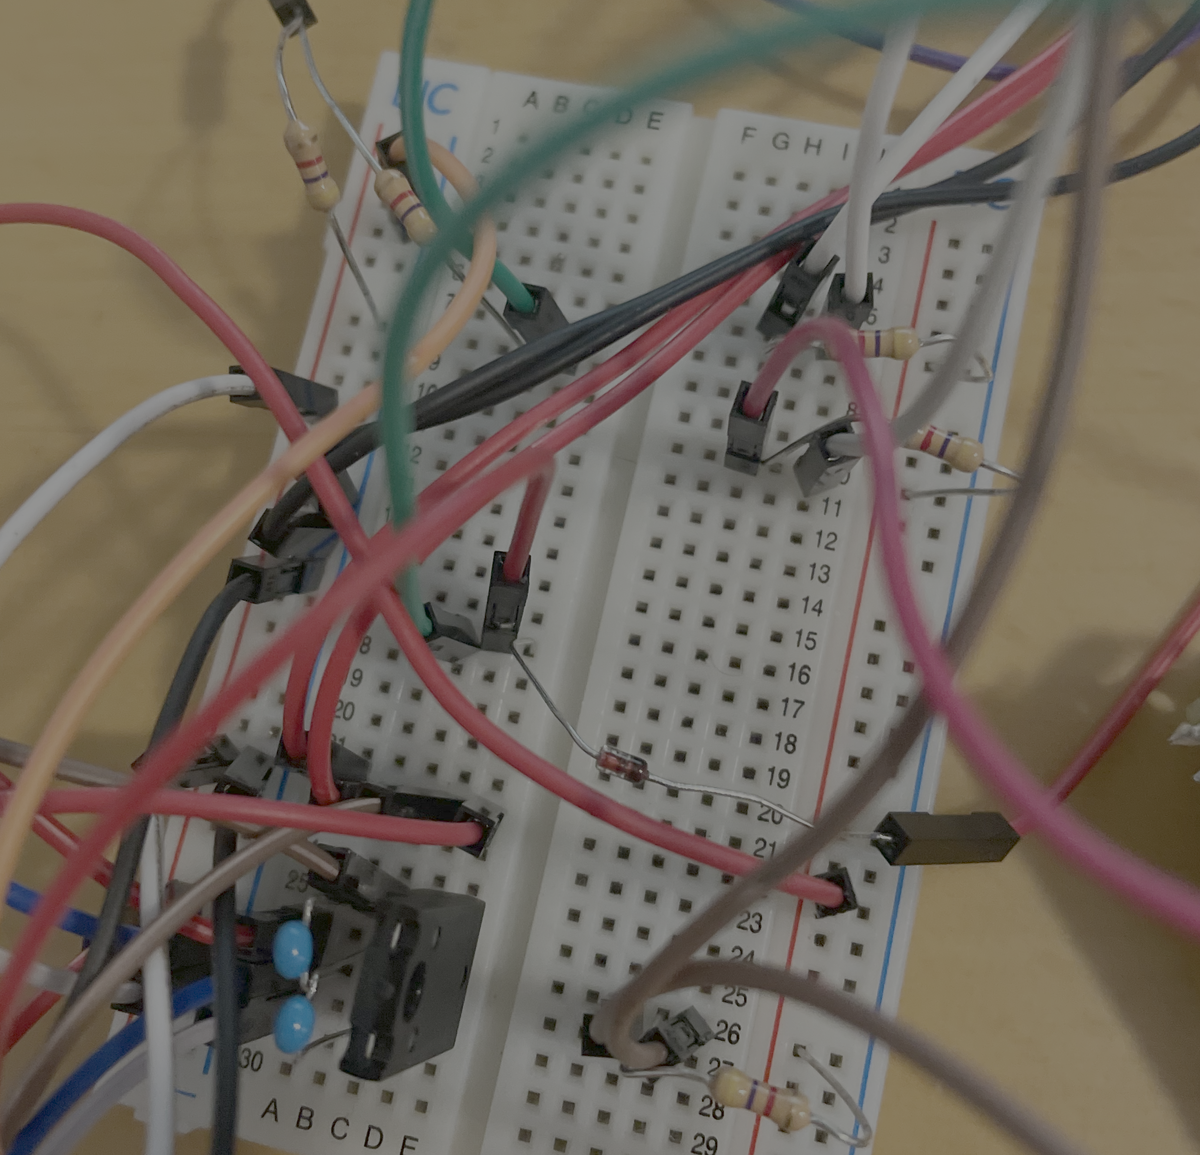
道具は Raspberry Pi Pico 2 とテスターだけ。オシロもロジアナもなし。


Phase 1: 無通電で導通マッピング。 25パッドとGND間の抵抗を総当たりすると、13本が 972kΩ±2kΩ できれいに揃った。同じ構造のデジタルI/Oが13本並んでいる —— この時点で「MIPIではなく8bitパラレルDVP」とほぼ確定(先人のCSI-2説をここで棄却)。パスコンの充電挙動から、電源3本・GND4本も特定。


Phase 2: 恐る恐る通電。 1.8Vコア+2.8Vアナログの2電源構成と仮定し、直列抵抗で電流制限しながら投入。2.0mA —— 生きている。


Phase 3–4: クロックを探す。 I2Cを試してもACKが返らない。数日悩んだ末、テスターで「未接続」と判定していたパッドが、実は MCLK(クロック入力) だと判明した(2MΩレンジのテスターは、浮いたCMOS入力を「未接続」と誤判定する。教訓)。PicoのPWMで1MHzを入れた瞬間、消費電流が 2.5→4.2mA に跳ね、ピンが動き出した。


Phase 5: 対話開始。I2Cアドレス0x22で応答。レジスタ0x0C–0x0Fに DC 05 4C 04 という「指紋」—— 16bitで読むと1500と1100、つまりフレームタイミング(行長1500クロック×総行数1100)だった。0x9Fに0x8Bを書くと、データが流れ出す。ただし、当時摘んだ呪文はこれだけで、実際にはあと二手必要だったと後で判明する(詳細は後述)。全256レジスタのマップも取得した。


PicoのPIO+DMAで掴んだ生フレーム(1280×278)。当時は「このセンサは縦を約1/4に間引いたモードで出力してくる」と思っていたが、後日これはキャプチャ側の制約だったと判明する。縦に潰れているが、既に何かが写っている。しかし、なにがうつっているか全然わからない。


写真が撮れるまでの地獄

ここから撮影成功までの道のりは長かった。症状は「I2Cは完璧なのに、映像出力されない」。容疑者は仮説ベースで8つ。ZIFコネクタの接圧、SDA/SCL短絡、電源の残留電荷、リセットタイミング、レジスタの隠しビット(全256レジスタ×全ビットを自動反転スキャンまでした)、電源の息切れ……。ほとんどはテストで棄却されたが、実はこの「隠しビット」仮説だけは正解だった(理由は後述)。


だが、真犯人(主犯格)は、拍子抜けするほど地味だった。


  1. AVDD供給線の 10.8Ω の接触不良(ブレッドボードの穴のへたり)
  2. GND線の斜め挿し(グランドバウンス。動き出すと自分のスイッチング電流でブラウンアウトする)
  3. リングライトのPWM調光(ローリングシャッターと干渉して画面に縞を刻む)


対策として、一時期はアナログ電源をPicoのGPIOから直接給電する構成まで試した(ソフトで電源ON/OFFできるので、センサの機嫌が悪いときに自動で電源サイクルを打てる)が、最終的には3V3からダイオードとパスコンで作った専用のAVDD島に落ち着いた。GNDはブレッドボードを捨ててPicoのGNDピンへ直結。ここまでやって、ようやくギリギリおぼろげな絵が出るようになった。


2026年7月26日朝。カーテンの隙間の光へ向けて、6分割キャプチャ(PicoのRAMにフレームが丸ごと載らないので、6回に分けて撮って合成する)。278行すべてが埋まった。


半信半疑の画像出現

1280×278(縦1/4間引き)を本来のアスペクトに引き伸ばしたもの。
ノイズまみれだが、確かになにかが写っている。


画質に関して。現在はデータ線8本のうち6本しか配線していないので現状6bit階調、露光制御レジスタも未調整、そしてセンサ自身が18年物で気まぐれ(午前は動くが午後は寝る。本当に。—— この正体は後述する)。それでも「詳細不明」が不鮮明ながら「写真が撮れるカメラ」となった。

そして、ついに、すべてが繋がった


ここで一旦終わるはずだった。


ところが今夜、検出器のバグに気づいてしまった。


当時のスキャナは「PCLKが立つかどうか」だけを監視していて、そもそも走査(HREF/データ)が始まっているかどうかを見ていなかった。


検出器を直して、棄却したはずの「レジスタの隠しビット」仮説を同じ手順でスキャンし直したところ、0x4Aのbit2がヒット —— これがGOビットだった。


正しい呪文は0x9F=8Bだけでは足りず、0x03=03と0x4A=04(GOビット)を追加で叩く必要があった。さらに、走査中はI2Cを定期的に読み続けないと数秒で出力が止まることも判明。


長年「気まぐれ」と呼んでいた午前/午後問題も、正体はこのGOビット未発見・I2Cのping切れによる凍結、そしてMCLKを6MHzに上げて壊した事故が重なっていただけだった。


ついでにもう一つ判明したことがある。1280×278という「縦1/4間引き」も、センサの仕様ではなくキャプチャ側の制約だった。


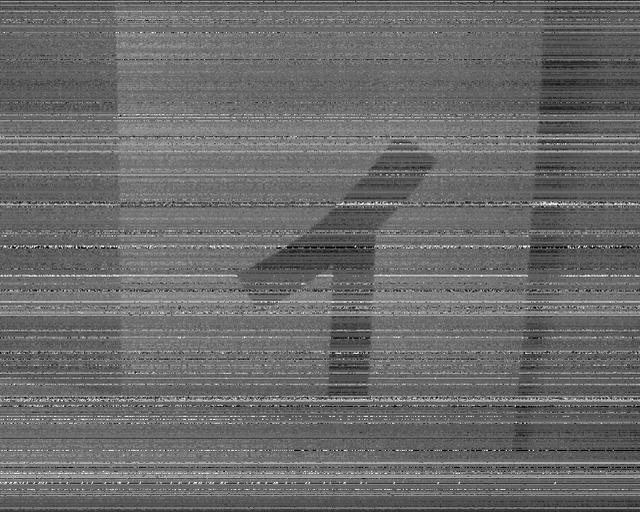
ここまできてついに、ネイティブ1280×1023行、SXGAフルフレームでの撮影に成功した。


GCM0105-1003Eが撮った、フルSXGA(1280×1023)フレーム。よく見ると「イ」の字が読み取れる。10年眠っていた¥100のセンサが、今夜ようやく日の目をみた瞬間。


で、中身は誰だったのか

レジスタマップと出力仕様を2007年前後のセンサと照合していくと、最有力は東芝のTCM824x系(Dynastron)の非公開後継/カスタム品だという。(Claude曰く)

  • 24パッド(データシート表記。実測フレキは25芯)、1.8V+2.8Vの2電源、アレイ1300×1040 —— 公開品TCM8240MDと一致
  • 1行の有効データ「2560クロック」—— データシートの記述と完全一致
  • YUV422のUYVY順(Y=奇数バイト)—— 一致
  • 「デフォルトで出力OFF、レジスタで解放」という設計思想 —— 一致
  • ただしI2Cアドレスとレジスタ配置は公開品と違う(=非公開の後継世代)。もう一点、データシート通りにMCLKを6MHzへ上げたら死んだ —— このPLLは1MHzでしかロックしないらしい、というのも「ただし」リストに追加しておく

ちなみにI2Cアドレス0x22を使うカメラセンサは、Linuxカーネル/Androidドライバ/オープンソース界を探した範囲では一例もない。閉鎖系の日本製センサというのがクロードの推理である。


まとめと、これから

  • 秋月の「詳細不明」¥100モジュールは、SMKが2006年に設計したSXGAカメラモジュールだった
  • 電源2系統・MCLK 1MHz(データシート上は6MHzだが、この個体のPLLは1MHzでしかロックしない)・I2Cアドレス0x22・0x9F=8B + 0x03=03 + 0x4A=04(GOビット)で出力ON。走査中はI2Cを定期的に読み続けないと数秒で止まる —— 動作の勘どころはここに尽きる
  • 在庫はまだ1万個以上ある。¥100で「センサの気持ちが分かるようになる教材」としては破格だと思う

次の野望は、データ線を8bit化して階調を4倍にすること。そして次のターゲット。

——このセンサで64×64px・1時間1コマ・BLE送信カメラノードを作ること。眠り続けた18年分、働いてもらおうか。


レジスタマップ・回路図・キャプチャスクリプト・棄却した仮説7つの墓標(と、墓場から生き返った1つ)を含む「解析の全記録」は、画像の鮮明化を終えたのち、追って公開する予定。10年間だれも掘らなかった¥100の沼、一緒にハマって時間を溶かしたい人はぜひフォロー。トゥギャザしようぜ。


Claude Codeへの感謝

今回の解析、配線計画からレジスタスキャン、そして今夜のGOビット発見まで、ほぼ全行程でClaude Codeと一緒に行った。人間側がテスターを握り、ハンダゴテを握り、穴だらけのパズルの穴埋めを手伝ってくれた。

¥100のセンサ相手に大の大人が夜を溶かすのを横目に、もう明日にしましょうと、いやいやながら、最後まで付き合ってくれてありがとう。

ということで、明日もよろしくね。

sekai-eye 世界を認知するカメラ

Raspberry Piカメラを使って、いろんなものを検出し観察する。
そんなことをしばらくやっている。


YOLO検出。何かを見つけて認識する。まずはそこからだが、
そこから徐々に広げていくのが、このシステムのコンセプトである。


車通りの多い時間、人が通る時間 ── よくあるAIカメラの活用法だ。
しかしCOCOのモデルには、まだまだ認識できないものが多数ある。
特にRaspiカメラでは、不鮮明な画像からの物体検出が意外とうまくいかなかったりする。


自前で学習することも可能だし、以前に比べれば自分のデータセットを作るのも
だいぶ楽になってきている。そういうアプローチも残しつつ、
世界を少しずつ認知していくのがこのプロジェクトのコンセプトである。

今回はその一例として、YOLO vs Sekai-Eyeの対比デモを紹介する。


よくある、車の検出。しかし「上から」の視点での検出には案外弱かったりする。

> 例えばドローンで真下に向けた画像の物体検出。
> 学習済みモデルが「車という見た目」を必要とするのに対し、このシステムは
> **「変化」さえあれば把握できる。古典的CVと領域知識だけで、YOLOが取りこぼす交通流を拾うことができる。


今回のデモの題材は、ロータリーを真上から撮った空撮クリップ1本。ここで起きる「物体検出の敗北」と、その回避策としての変化駆動パーセプションである。


*真上視点のロータリー。赤=YOLO(yolov8n)、緑=Sekai-Eyeが動きで拾った車。YOLOは1、Sekai-Eyeは50。*


1. なぜ真上だとYOLOは検出できないのか?

YOLOやCOCO系の検出器は、**地上・目線レベルの写真**で学習されている。「車」の教師画像は、
側面や斜め前方からの、タイヤ・フロントガラス・ボンネットが見えるものがほとんど。

ところが真上から見た車は ただの長方形の屋根。タイヤもガラスも見えない。
モデルが学んだ「車らしさ」の特徴がほぼ消えるため、検出されにくいといわけだ。


実際、この4Kクリップを各フレームYOLOに通すと、検出される車両は常時0〜2台。
しかも時々、赤い屋根の建物を「車」と誤検出している(下図左下の赤枠)。
真上視点では、検出器は車を見失うどころか、屋根を車と取り違える。


2. 複数の画像で「変化」を見る

Sekai-Eyeの設計思想。

静物を認識したいという時もあるが、このシステムは小さな変化をとらえるというところに重きをおいている。

そこで動きに着目した実装を盛り込んだ。これが変化駆動パーセプションである。

パイプラインは古典的CVのみ。学習パラメータ0、GPU不要、CPUで回る。


フレーム列 → 背景差分(MOG2) → ロードマスクで路面に限定 → サイズ制限 → 連結成分=車 → カウント


2-1. 背景差分(MOG2)

python
mog = cv2.createBackgroundSubtractorMOG2(history=120, varThreshold=24, detectShadows=False)
fg = mog.apply(frame, learningRate=0.5 if first else 0.02)

動いている車だけが前景に出る。**駐車車両は背景に溶けて消える**ので、
「実際に動いている交通」だけがクリーンに残るのが嬉しい点です。

ただしこれだけでは、木々の揺れ・水面のゆらぎ・ドローンの微小なドレ(撮影ブレ)・
JPEG圧縮ノイズまで前景化し、1フレームで**400以上の偽ボックス**が出てしまうことに


3. ロードマスク:誤検出との戦い

「車は道路の上にいる」── この当たり前の**領域知識(ワールドの法則)**を効かせる。
路面以外の動きは無視する。問題は「どうやって路面だけを取り出すか」。


3-1. まずはHSVマスク(失敗)

最初は「アスファルト=灰色=低彩度」でマスクを作りました。


python
road = (S < 42) & (V > 55) & (V < 200)   # 灰色=低彩度・中明度

結果はイマイチ。**乾いた茶色の畑・ベージュの建物屋根も低彩度**なので一緒に塗られ、
さらに**ロータリー中央の星形モニュメント**まで路面扱いになり、その高コントラスト模様が
ドローンの微小ドレで誤発火。色だけでは路面と非路面を分離できない。


3-2. sekai-eye仕様:連結フラッドフィル(採用)

そこで本体の道路検出 `refine_road_bucket` に切り替えました。位置づけは
**「Photoshopの“隣接”バケツ塗りの内部実装」**です。

- 人が道路の概形ポリゴンを指す(**人間確認**)
- そのポリゴン内部をシードに、**連結した同色アスファルトだけ**を `cv2.floodFill` で塗る
- 膨張帯(margin)の外は塗り禁止にして暴走を防ぐ


python
def refine_road_bucket(bgr, polygon, tol=12, margin=38):
    region = _mask(bgr.shape, [polygon])
    band = cv2.dilate(region, kernel(margin)) > 0        # 塗ってよい帯
    seed = cv2.erode(region, k9) > 0                     # 縁を避けた内部コアから種をまく
    for (x, y) in sample(seed):
        cv2.floodFill(img, ff, (x, y), 0, (tol,)*3, (tol,)*3,
                      4 | (255 << 8) | cv2.FLOODFILL_MASK_ONLY)
    return grown


**色の連結性**で塗るので、

- 離れた屋根・遠くの畑には**飛び火しない**(非連結だから)
- 砂利・草・畑との**色境界で自然に止まる**

「色が似ているが繋がっていない」ものを除外できるのが、単純な色マスクとの決定的な差である。

とはいえ、マスクの作成はまだ未完成なので必要に応じて手動で作った方が良い場合もあるかもしれない。


このシステムの特徴は、人が介在して、育てるというコンセプトで作っている。

もちろん全自動で行ければ全自動で良いのだが、どうせまだまだ試行錯誤中なので、苦手なところは人間が補助すれば良いというコンセプトで進めている。


3-3. 中央モニュメントは「アヌラス(ドーナツ)」で穴抜き

ロータリーの走行リングだけを指し、中央の星形モニュメントを外すために、
道路帯ポリゴンを**楕円アヌラス**で定義しました。


python
def _ellipse_annulus(cx, cy, rx_o, ry_o, rx_i, ry_i, n=48):
    outer = [楕円(外周)]
    inner = [楕円(内周, 逆回り)]
    return outer + inner + [outer[0]]      # fillPolyで中抜きの円環になる

これでシードが中央島に落ちず、フラッドフィルもモニュメントへ侵入せずにすむ。


3-4. 正直な限界

万能ではありません。このクリップでは乾いた畑・砂利広場がアスファルトとほぼ同色で、色連結が一部それらを越えて漏れます(`tol` を下げて緩和)。
俯瞰・低コントラスト素材ではこの種の「色が近すぎて分離できない」場面が必ず残ります。
ただし動きのない領域なので背景差分が発火せず、次のサイズ制限と合わせれることで問題を緩和している。


4. サイズ制限:1台=1ボックスに寄せる

最後に、断片化と過大ブロブを処理してしまうので対策。

- **断片マージ**:1台が複数ブロブに割れるので、ブロブを描画→膨張→再輪郭で連結
- **サイズ制限**:乗用車 ≈ 25×40px(面積~1000)。上限を**その約3倍**(バス/トラック相当)に。
  これ超えは「複数台の結合・影・揺らぎ」として棄却


python
CAR_AREA = 1000
MAX_AREA = CAR_AREA * 3       # 乗用車の約3倍まで
MAX_DIM  = 80
if not (6 < w and 6 < h and max(w, h) <= MAX_DIM and 30 < w*h <= MAX_AREA):
    continue                  # 微小ノイズと過大ブロブを両端で落とす

この一手で、検出が**乗用車サイズで均一**になり、数が「ノイズの水増し」ではなく
「実際に動いている車の台数」として読める値になった。

**偽ボックスの推移:476 → 130(ロードマスク)→ 66(断片マージ)→ 50前後(サイズ制限)**


 5. 結果

  YOLO (yolov8n) Sekai-Eye(変化駆動)
検出台数 0〜2 50〜100
誤検出 赤い屋根を車と誤認 路面外を除外済み
学習 COCO(目線レベル) 学習なし・古典的CVのみ
計算 GPU想定 CPUで十分


真上視点で、汎用検出器は車を「屋根」に潰されて見失う。
一方、変化駆動パーセプションは見た目を問わず動きで交通流を追い続けることができる。
これは「大きい物体はYOLOで取れるが、点になるまで遠ざかると消える。Sekai-Eyeはそこで終わらない」
という、俯瞰観測の本質的な強みの可視化です。


 6. 設計上の学び(CV実務者向け)

1. 巨大単一モデルがいつも正解ではない。俯瞰・ぼかし・微小という条件では、
   学習済み検出器の前提(見た目)が崩れる。タスクの幾何を疑え。


2. 「認識」と「変化検出」は別物。対象が何に見えるか不明でも、
   時系列の変化なら拾える。問題を「検出」から「変化+領域知識」に組み替える。


3. 領域知識は色でなく連結性で表現する。「低彩度=路面」は屋根・畑に漏れる。
   「シードから繋がった同色」なら非連結の偽陽性を構造的に排除できる。


4. 人間が指し、機械が塗る。完全自動を狙わず、人が道路の概形を1回指すだけで、
   バケツ塗りが実体に沿って広げる。ヒューリスティックと人間確認のハイブリッドは強い。


5. 数の誠実さ。断片やノイズを足した「盛った数字」は逆効果。
   サイズ制限と1台=1ボックス化で、見た人が信頼できる値にする。


付録:再現方法

bash
cd demo
# ロードマスク単体検証(demo/roadmask_*.jpg を出力)
python3 road_detect.py

# デモ動画の生成(各フレームでYOLO APIを叩く)
python3 render_topdown.py --start 40 --n 260 --step 2
# 出力: demo/sekai_vs_yolo_topdown.mp4


| ファイル | 役割 |
|---|---|
| `render_topdown.py` | レンダラ(MOG2+ロードマスク+サイズ制限+YOLO比較+ZOOM) |
| `road_detect.py` | sekai-eye仕様ロードマップ検出(本体 `refine_road_bucket` を利用) |
| `roadmask_*.jpg` | ロードマスク検証画像 |
| `sekai_vs_yolo_topdown.mp4` | デモ動画 |


**素材**:Pexels 1472013(Tom Fisk, Pexels License・商用可/帰属不要)。
真上ナディアのドローン空撮。


Sekai-Eyeの設計思想は「外部の正解に頼らず、自分の目で見て理解する」。
天文APIを使わずとも、明るさで日の出を知り、気象APIでなく鮮明度で雨を把握、

なんだったら、風の強度も木々の揺れで把握。

YoLOも使用するが、そこで終わりではなく、さまざまな要素を繋げて、ハイブリッドな仕組みとしている。

物体検出でなく**動きで交通を知る**。
引き続き、観察対象を広げており、徐々に把握できる対象やシーンは増えているので

また機会があれば紹介したいと思う。

赤がYOLO、緑の枠がsekai-eyeということで、Yoloがダメでもsekai-eyeがあるじゃない。という事である。

「現金のみ」の店は汚いのか? Google Mapsのデータ3,700店舗で検証

現金しか使えない飲食店って、なんとなく古くて不衛生そうなイメージはあるけど、それってデータで確認できたりするのかな?ということで、今回はデータ解析を行ってみた。


Google Maps APIで東京都内の飲食店3,735店舗、レビュー約1.8万件を収集し、「現金のみ」という属性が実際に何と相関しているのかを統計的に分析。


先に結論を書いてしまうと、

「現金のみ」と衛生感(今回は害虫出没に注目)との相関はみつけられなかった。

その一方で、「現金のみ」は価格帯・業態との関係性が読めた。。


どうやって調べたか

2026年6月、新宿・渋谷・池袋・上野・浅草・赤羽・蒲田・北千住など、都内の主要エリアの飲食店をGoogle Places APIで収集。

- 店舗数: 3,735店舗(うち現金のみ497、カード可2,831、不明407)
- レビュー数: 18,078件(APIの仕様上、店舗あたり最大5件)

レビュー本文に対しては、キーワード抽出だけでなくLLMによる分類も併用。


たとえば「ゴキブリ」という単語が出てきても、「ゴキブリ一匹いない清潔な店」のような文脈は害虫言及から除外する、といった処理だ。単純なキーワードマッチだと、こういう偽陽性がけっこう混ざってしまう。


なお、以下に出てくる「OR(オッズ比)」は、ざっくり言えば「ある属性を持つ店が、持たない店に比べて何倍そうなりやすいか」を表す数値。1なら差なし、大きいほど強い関連、1未満なら逆方向の関連と読んでほしい。


 検証1: 害虫仮説——相関なし

本丸の「現金のみ店舗は汚い」説。レビュー中の害虫言及(LLMで文脈分類した後の「真の言及」)を比較した。

- 現金のみ: 2/497店 = 0.40%
- カード可: 15/2,831店 = 0.53%

むしろ現金のみのほうがわずかに低いくらいで、統計的には完全に差なし(OR=0.76, p=1.0)。「現金のみ店舗は害虫が出やすい」という大きな効果は、データからみつけられなかった。


そもそも害虫言及自体が全体で0.5%程度しかなく、ごく弱い差まで検出するにはサンプルが足りない、という限界はある。それでも「現金のみ=不衛生」と言えるような関連は見当たらなかった。


検証2: 価格帯——強い相関

では「現金のみ」は何と相関しているのか。まずはっきり出たのが価格帯。

  低価格 普通 高い
現金のみ 40.4% 58.5% 1.1%
カード可  25.7% 67.3% 6.9%


現金のみ店舗は低価格帯に明確に集中している。業態や店齢などの影響を取り除いた多変量解析でも、価格帯が1段階上がるごとに「現金のみ」である確率は約1/3に減る(OR=0.33, p<0.001)という強い関係が残った。


決済手数料が利益率を直撃する低価格業態ほど現金にとどまる、という構造的な説明と整合する結果となった。


検証3: ラーメン店——価格を考慮しても突出

業態別に見ると、ラーメン店が突出していた。価格帯を調整したうえでなお、**ラーメン店は他業態の6倍「現金のみ」になりやすい**(OR=6.0, p<0.001)。券売機文化の影響が強く疑われる。

ただし、ラーメン店を内訳で見ると一枚岩ではない。

- 低価格帯: 現金のみ率 74.4%
- 普通〜高価格帯(評価4.2未満): 51.2%
- 高評価かつ高価格帯: 37.7%

つまり「ラーメン店=現金のみ」を牽引しているのは、伝統的な低価格・券売機オペレーションの店。高級路線やインバウンドを意識した店ではキャッシュレス化が進んでおり、同じ「ラーメン店」の中でも分化が起きている。


検証4: ワンオペ——「見かけの相関」の教科書的な例

レビュー中の「ワンオペ」言及も調べた。単純に集計すると、現金のみ店舗のほうが2.45倍多くワンオペに言及されている。「やっぱり現金のみの店は人手が足りてないんだ」と結論したくなるところだが、これが落とし穴だった。


業態を考慮した多変量解析にかけると、「現金のみ」の効果は消えてしまう(OR=1.39, 非有意)。代わりに効いていたのはラーメン店であること(OR=3.92)。


これは交絡(confounding)の典型例だ。「現金のみ」と「ワンオペ」が直接つながっているのではなく、券売機+カウンター営業という省人化設計の業態が、現金のみとワンオペの両方を生んでいる。第三の要因が背後にいるせいで、無関係な2つが相関して見えるパターンだ。


ただし話はもう一段続く。ワンオペ言及200件をLLMで「不満」「中立」「肯定」に分類し、不満(NEGATIVE)だけに絞って再分析すると、今度は現金のみの効果が復活した(OR=1.99, p=0.047)。一方でラーメン店の効果は消える。


解釈するとこうなる。ラーメン店のワンオペは「設計として効率化された営業形態」なので、客はそれを不満として書かない。一方、不満として書かれるワンオペ——繁忙時に回っていない、待たされる——は業態とは別の要因(人手不足など)を反映しており、それが現金のみ店舗側に弱く偏っている可能性がある。同じ「ワンオペ」でも、語られ方によって背後にあるものが違うわけだ。


検証5: いちばん面白かった発見——「雰囲気」は語る対象になりにくい

レビューの語彙も分析した。「安い」「早い」「コスパ」といった機能系の言葉と、「雰囲気」「おしゃれ」「デート」といった体験系の言葉、それぞれの出現率を比較する。


語彙カテゴリ 現金のみ カード可 結果
安い・早い系 67.2%  64.1% 差なし
雰囲気・体験系  56.9% 72.8% 有意差あり (OR=0.49)


直感的には「現金のみの店は『安い・早い』と多く書かれるはず」と予想していたが、機能系語彙には差がなかった。差が出たのは逆で、体験系の語彙だ。


つまり現金のみ店舗では、レビューで「雰囲気」「おしゃれ」「デート」といった体験系の言葉が出現する確率が、カード可の店より16ポイント低い(56.9% vs 72.8%)。これは何を意味するか。客がその店について語る価値の軸が、空間や体験ではなく機能・実用に寄っているということだ。


言い換えれば、カード可の店では「この雰囲気が好き」「デートに使える」といった、空間体験に関する言及が当たり前のように出てくる。


一方、現金のみ店ではそうした「ここの良さは何か」という語りが、統計的に少ない。低価格・省人化という店舗設計が、レビューの語彙という形で顧客側の着眼点にまで反映されている。個人的にはこれが今回いちばん面白い結果だった。


検証6: 古い店だから現金のみ説——支持されず

最後に、「昔からやっている店ほどキャッシュレス対応が遅れている」という慣性仮説。レビューの最古日付を店齢の代理指標として検証したが、係数はむしろ負(古い店ほど現金のみ、とはなっていない)で、慣性説を支持する証拠は得られなかった。

「現金のみ」は過去からの取り残しではなく、現在進行形の経営判断・業態設計の結果と見るほうがデータには合っている。


まとめ: 「現金のみ」は何のシグナルか


相関する属性 強さ  解釈
低価格帯 強  低コスト運営・低価格設定
ラーメン店 強 券売機文化・省人化設計(高級路線では低下)
「雰囲気」語彙の少なさ 中 機能重視の顧客体験
ワンオペへの不満 弱  業態とは独立した人手不足の可能性
害虫言及 なし 衛生リスクとは無関係 
店齢 なし レガシー・慣性とは無関係


「現金のみ」という選択は、単なる決済方法ではなく、経営判断の表れだ。


キャッシュレス対応の券売機は存在し、理論的には導入は可能。なのに多くの低価格帯の店舗が「現金のみ」を選び続けているのは、キャッシュレス手数料をどう見なすか、という判断の違いを示している。


「避けるべきコスト」と見なす店は、限られた資本で低価格を成立させることを優先する。現金のみ、券売機、ワンオペ——すべてが必要条件として機能し、その結果、顧客も「機能」の視点でその店を語る。「安い」「早い」が支配的で、「雰囲気」は背景に退く。


「必要なアップデート」と見なす店は、手数料を投資として、顧客体験の向上に充てる。高価格化、サービス充実、空間への投資が進み、顧客もまた「この雰囲気が好き」という体験的価値を語るようになる。


つまり、「現金のみ」の貼り紙は、衛生状態ではなく、その店が「どういう顧客に、どういう価値を提供するのか」という戦略そのものを示すシグナル。そしてその戦略は、客がその店をどう語るかに反映されている。


留意点

最後に、この分析の限界も正直に書いておく。Google Places APIは店舗あたり最大5件のレビューしか返さないため、語彙分析の網羅性には限界がある。対象は都内の繁華街中心で、郊外や地方では事情が異なる可能性がある。また観察データなので、ここで示したのはあくまで相関であって因果ではない。「キャッシュレスを導入すれば雰囲気が良くなる」という話ではない点には注意してほしい。


それでも、「なんとなくのイメージ」を3,700店舗のデータに当てて確かめると、いくつかの仮説はマッチせず、代わりに業態設計と顧客の語りという別の構造が見えてくる——そういう点ではよい検証だったと思う。

【風を見たかい】画像を使った風の検出

カメラ1台で「風」を見る ― 光学フローによる植生の動き解析

最近、Raspberry Piにいろいろなものを観察させて世界を認識させる、という検証を続けている。

その一環で、1分おきに撮影した画像から遠くの木々の揺れを拾い上げて、風の強弱を検出するということを試してみた。


普通なら風速計で測るのが正解だと思うが、今回は光学フロー (Optical Flow) でカメラ画像から風を見る、という話。


Optical Flowという言葉の時点で、ああなるほどと思う方も多いかもしれないが、もう少し説明を続けたい。


強風


- 木の葉が揺れる
- 草がなびく
- 旗がはためく


いうまでもなく、風速計がなくでも画像から、風を感じることが可能である。


私の撮影画像の場合は、建物を含む画像の中に木々が存在する画像だった。

そこで、

1. 画像から緑色の領域 (植生) を抽出
2. 連続フレーム間の動きを光学フローで計測
3. 植生エリアの動き量から風レベルを判定

という単純な3ステップで構成された実装である


実装

1. 光学フロー計算 (Farneback法)

OpenCVの`calcOpticalFlowFarneback`で、連続する2フレーム間のピクセル移動ベクトルを密に計算する。

```python
flow = cv2.calcOpticalFlowFarneback(
    gray1, gray2, None,
    pyr_scale=0.5,    # ピラミッドスケール
    levels=3,          # ピラミッド層数
    winsize=15,        # 窓サイズ
    iterations=3,      # 反復回数
    poly_n=5,          # 多項式展開の近傍サイズ
    poly_sigma=1.2,    # ガウシアン標準偏差
    flags=0
)
```

Lucas-Kanade (疎なフロー) ではなく密なFarnebackを選んだのは、植生マスク内の全ピクセルから統計量を取りたかったため。


2. 植生エリアの抽出 (HSV緑色マスク)

HSV色空間で緑系の領域だけを切り出す。

```python
lower_green = np.array([35, 30, 30])   # H, S, V
upper_green = np.array([85, 255, 255])

hsv = cv2.cvtColor(img, cv2.COLOR_BGR2HSV)
green_mask = cv2.inRange(hsv, lower_green, upper_green)
```

Hue 35-85 の範囲で、深緑から黄緑までの植生をだいたい捉えられる。シンプルだが、まずこれで様子を見る。


3. 植生エリア内の動き量を測定

植生マスク内のピクセルについて、フローベクトルの大きさ (magnitude) の平均値を `green_motion` として算出する。

```python
mag, ang = cv2.cartToPolar(flow[..., 0], flow[..., 1])
green_pixels = mag[green_mask > 0]
green_motion = green_pixels.mean()
```

ここがミソで、画像全体の平均ではなく**「緑のピクセルだけ」の平均**を取ることで、人や車の動きを大幅に弾ける。


4. 風レベル判定

`green_motion` を経験的な閾値で4段階に分類する。

| green_motion | 風レベル | 実風速の目安 |
|--------------|---------|-------------|
| < 0.08       | none    | < 1.5 m/s (静穏) |
| 0.08 - 0.12  | light   | 1.5 - 3.3 m/s (軽風) |
| 0.12 - 0.18  | moderate| 3.4 - 5.4 m/s (軟風) |
| > 0.18       | strong  | > 5.5 m/s (和風以上) |

閾値は気象庁のビューフォート風力階級を意識して、実測との対応で適当にチューニングしてある。


検証

自宅カメラ × 気象庁データ

自宅Raspberry Piカメラの連続フレームと、最寄りアメダスの観測値を突き合わせた。

| 日時 | 気象庁風速 | green_motion | 検出結果 |
|------|-----------|--------------|---------|
| 2026/04/30 14:00 | 1.4-1.8 m/s | 0.04-0.07 | none ✓ |
| 2026/05/02 09:00 | 3.5 m/s | 0.12-0.17 | moderate ✓ |

風速3.5 m/s (軟風) と1.5 m/s (静穏) の間で `green_motion` におよそ2.4倍の差がついており、肉眼でもグラフでも明確に判別できた。


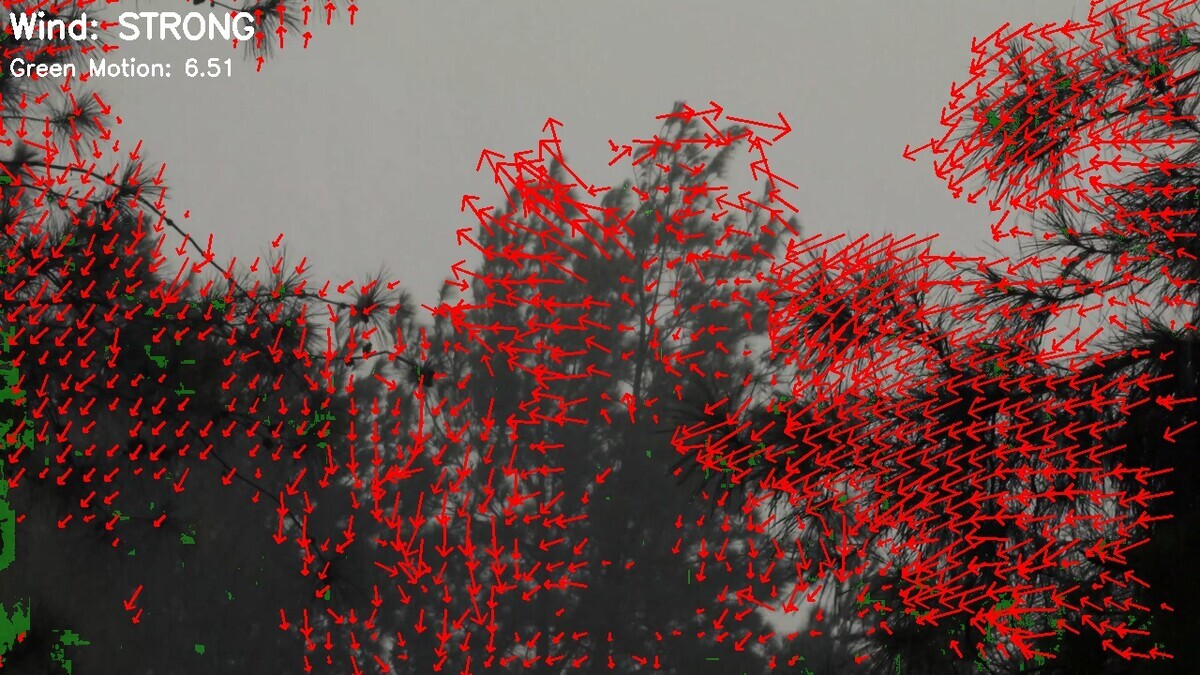
自宅環境は、素材の関係でそのまま公開できないので、Pexelsの公開動画を使用したテストが、冒頭の画像である。


- [Trees Swaying in the Wind on a Stormy Day](https://www.pexels.com/video/3864103/) — 嵐の日の木々

- [Rainfall Over Trees]
(https://www.pexels.com/video/10359300/) — 雨天時の木々


| シーン | green_motion | 検出結果 |
|--------|-------------|---------|
| 嵐の木々 | 6.51 | STRONG |
| 雨天の木々 | 4.94 | STRONG |


どちらも閾値0.18を1桁以上超えていて、強風として正しく分類された。閾値の上限側は今回データ不足で詰めきれていないが、少なくとも「強風かそうでないか」の境界としては機能している。


可視化

動作確認用にデバッグ表示も書いた。

- **赤い矢印**: 光学フローベクトル (動きの方向と大きさ)

矢印が木や草の部分に集中して表示されるので、「いま何を見て風と判断しているか」が一目でわかる。


制限事項

いくつか試してみてわかったこと

- **撮影間隔**: 長すぎるとフローが破綻する。推奨1分以内、理想は数秒間隔
- **夜間・雨天**: 緑のHSVマスクが効かなくなる。
- **カメラの揺れ**: 三脚固定が必須。手持ちは論外
- **季節**: 落葉時期は検出対象が物理的に減るので、常緑樹を画角に入れる工夫がいる
- **閾値の場所依存性**: 同じ風速でも、画角に占める植生量や樹種で `green_motion` が変わる。場所ごとのキャリブレーションは必要


応用可能性

このまま実用というより、「カメラだけある環境で何かしら風情報を相対的に定量化したい」というときに使えるかも。

- **自律気象観測**: 風速計なしで簡易風況把握
- **農業**: 圃場カメラから作物への風ストレスモニタリング
- **建築**: ビル風の簡易測定 (定点カメラを並べる)
- **防災**: 強風警戒の補助情報、河川監視カメラの副次活用

 とはいえ、防災用途なら風速計をつけたらよいと思う。


まとめ

光学フロー + HSV色フィルタリングという、ごく簡単な組み合わせだけで、カメラ映像から風の有無と強さがそれなりに推定できることを確認した。


精度は当然、専用センサーと比べるものではないが、風を見るという観点で面白かったので紹介。


- 追加ハードウェアが要らない
- 既存の監視カメラ資産を流用できる
- ロジックが透明で説明しやすい

という点は評価ポイントかもしれない。


## 関連研究

より厳密な学術的アプローチとして以下のようなものがあった

www.sciencedirect.com


複数の風速レベルでラベル付けされた映像データセットで、ちゃんと精度評価したい場合はこちらを参照いただくとよいかと思う。


【自分専用】[飲食店口コミサイト]+[プロンプトジェネレーター]

今回の話は、一言で言うと 自分専用食べログを作ってそこに「プロンプトジェネレータ」を組み込んでみたら意外と良さげだった という話である。

多少前置きも説明しておく。


しばらく以前から自分が取り組んでいるネタとして、「自分専用のAIエージェントを作る」というものがある。

自分用のエージェントと、汎用的エージェントのコンセプトの違いは、平たく言えば、どこまで、自分に特化させるか否かかと思う。

ChatGPTに自分の情報ゼロで、「このあたりのおすすめの飲食店教えて」と言っても、その辺りの人気店をピックアップしてくれるだけだろう。
これに、自分の嗜好や、状況を加えてオーダーすることで、少し回答結果が変わるはずである。

で、じゃあ自分の嗜好伝えるにはどうしたらよいだろうか?
「私は●●が好きです。良さそうな店を紹介してください」
まあ悪くないと思う。しかし、人間というのは自分の事がわかっているようでわかってなかったりするのである。つまり「●●が好き」という自己認識はあながち間違いではないものの、自分は気がついてないかもしれないけど、「こんなのもどうですか?」というレコメンドがあるかないかで、人はそのレコメンドにちょっと気が利いているなと感じるポイントとなる。

それでは具体的に、どうしたらよいだろうか?
SNSでいいねを何回か押せば、その人の嗜好がわかると言われる。
基本的な発想はそのあたりに基づき、自分の足跡をDBに組み込む。

ということで、まずは自分用データベース(自分用の食べログ的なシステム)

の作成からのスタート。

いきなり「Claude code」で作り始めると、振り回されるので、まずはChat GPTやClaudeにざっとした構成を相談しつつ、ある程度構成をまとめるのがプロの流儀である。知らんけど。
構成がまったところで、それをCLAUDE.mdに入れて、システム開発という名の丸投げを実行。

---

プロジェクト概要:自分用の食べログ

構成はシンプル

[普段使いのMac]                    [Ubuntu Node(古いMacbookPro)]
 開発・推薦UI                       常時稼働データノード
 ├── Streamlit UI                  ├── Docker
 ├── Claude API呼び出し             ├── Qdrant(ベクトルDB)
 ├── ChatGPT API呼び出し            ├── 定期収集スクリプト
 └── 開発・デバッグ                  └── 店舗データAPI(FastAPI)
         ↕ LAN同期


普段使いのMacで開発とUIを動かし、引退前の MacBook Pro をデータノードにしている。
Qdrant(ベクトルDB)にレストラン情報を蓄積し、訪問履歴・個人評価・メモを書き込んでいくと、そのうち「自分だけの食べログ」が育つ、という算段。
(開発部分はほとんどAIに丸投げなので、あまり技術的なバックグランドは把握してない。)

店舗データのスキーマはこんな感じ。

```python
{
    "name": "店舗名",
    "genre": ["ラーメン", "つけ麺"],
    "price_range": "800-1200",
    "distance_min": 5,
    "cashless": True,
    "strengths": ["深夜営業", "一人OK"],
    "weaknesses": ["現金のみ", "行列"],
    "last_visited": None,
    "visit_count": 0,
    "my_rating": None,
    "memo": "",
    "embedding": [],
}
```

Google Maps Places API で近隣店舗を収集し、Claude API で構造化、Qdrant に永続化 ― ここまでは Phase 3 として完了済み。すでに近所の店舗が数十件、ローカルに蓄えられている。

できた検索画面はこんな感じ。


(自分用食べログの検索一覧画面)


使用したDBのほうは以下のような手法で集めた


1.グーグルマップ(保存機能)の「行きたい」「行った」などの店舗情報をとってくる。

2.食事記録アプリ mil の過去データ(自分の投稿)を取ってくる。

この辺のDBの集め方は、人それぞれかと思う。 自分がSNSでいいねしたような飲食店や食べ物リストをもとにするのもありだろうし、1週間の外食メモをCSVにしてもよいだろう。

ちなみにこのプロジェクトでは飲食店レコメンドにとどまらず、自分用DB + LLMという構成で、他のジャンル(音楽など)にも広げていくことを念頭においている。


今回のメインテーマ:プロンプトジェネレータという手抜き実装

ともかく、自分用食べログが作成でき、それはそれであるいみ完成なわけだが、
旅行時や、出張時に、自分向けの飲食店レコメンドが使いたいなと時々思うので、それの実装方法を考えてみる。

根底にある発想としては、自分用食べログの横展開である。
趣味嗜好は、すでにここに盛り込まれているので、その要素をうまく活用しながら、別の場所に応用するという事である。

最初は、趣味嗜好をJSONにして、APIでLLMにわたして返してもらうという流れを考えていたが、手抜き実装として、プロンプトを作成するだけで、あとはそれを自分でコピペして使えばいいじゃないということになった。

このアプローチの良い点

・「場所」だけ書き換えてやれば、応用が効く点。
・DBは生きている(更新してやれば最新になる)ので
 それに基づいたプロンプトも生きたプロンプトになる。
・プロンプトを見ればどういうオーダーに基づいたものかわかるし
 必要に応じて削除・追加も可能

新潟駅周辺で試してみた

ということで、先日旅行で訪れた、新潟駅周辺で試してた。
帰ってきた5件のうち2件は、実際にいった所だった。
つまり、レコメンドはうまく機能していると考えた。
(単にメジャーなところに行っただけという可能性もあるが。)

(プロンプトジェネレータの入力画面)


入力するのは探したいエリアだけ


おわりに

プロンプトエンジニアリングという大層な名前のつく手法があるわけだが、基本的にはコピペでよい。
しかしコピペの応用すら面倒になってしまった我々堕落した人類に、この自分専用DB+プロンプトジェネレータという発想は意外と便利なのではないだろうか


最後にプロンプトの例


あなたは私の食の好みを理解したグルメアドバイザーです。  

## 私の食の好み  ### 好きなジャンル(評価順) 
- カレー ★★★★★
- 喫茶 ★★★★★
- ラーメン ★★★★★


### 高評価した店舗の傾向
- ハンバーガー: 4件
- ラーメン: 4件
- カフェ: 3件


### 好きな店舗の例
- 七丁目のカレー屋(カレー)
- 星乃珈琲店 六本木店(カフェ, 喫茶)


## リクエスト

**新潟駅周辺**で、私の好みに合いそうな飲食店を5件おすすめしてください。

各店舗について以下を教えてください:
1. 店名
2. ジャンル
3. おすすめ理由(私の好みとの関連)
4. 価格帯
5. 駅からの距離
6. 食べログまたはGoogle MapsのURL


AIでシンクする

今回はキッチンでのAI検出を試してみた。


以前、コップに入った水や水滴を検出しようとしたのだが、水モノは結構難しい。

透明なのと、形が様々というのがその理由である。


最近あまり使ってなかった、Raspiのカメラで撮影。

まずためしてみたのが、食器を検出してLINEで通知するというもの。

検出はYoloでそのまま検出するだけなのだが、従来のYoloだと、検出できる対象が限られてしまい、あまり面白くないので、YOLO-Worldモデルを使ってみる。
YOLO-Worldというのが、こんなもんかとわかったところで、もうすこし欲張ってみる。


LLM Vision APIを使い、説明を強化する。

まず、GPT-4V、ローカルのOllamaに画像をそのまま見せて、「シンクに何があるか全部教えて」とJSON式で答えさせる。物体名、日本語名、カテゴリ、位置、シンクの清潔度を返してくれる。

Ollamaはローカルで実行できる点がよいが、処理が重い。(私の環境だと5分ぐらいかかる)

そんなに頻繁にシーンが変わるわけではないので、それでも良いと言えばよいのだが、やっぱ5分は長いなと思うので、GPT-4Vを採用。


さらに日数をかけてその後いくつか試してみたのだが、説明が長くなるので、今日はこのぐらいで。

ここまでの処理フローをまとめると:

  1. Raspberry Piのカメラでシンクを定期撮影
  2. 前回との差分を比較し、変化があればLINEで通知
    (洗い物がたまってますのニュアンス)
  3. LLM Vision APIに画像を投げ、物体リスト+清潔度を取得(ボタン実行オプション)
  4. YOLO-Worldでバウンディングボックス付きの検出を実行(ボタン実行オプション)

LLMの意味理解とYOLO-Worldの空間認識を組み合わせることで、「何が」洗い物として溜まっているかを判定できる。